Saltar al contenido
Buscar
Ver todo el radar

El radar

IA resuelve una conjetura de 2008 sobre ventajas cuánticas

Un sistema de investigación de PSI, con un modelo no público de Anthropic, encontró la demostración de la conjetura Aaronson-Ambainis. El resultado acota cuándo un algoritmo cuántico necesita leer menos datos que uno clásico, algo relevante si investigas algoritmos cuánticos o sigues el papel de la IA en matemática.

  • The Quantum Insider: AI-Assisted Proof Settles Longstanding Question About Quantum Speedups
  • Lo cubre Cipher
  • En cola para una clase

Qué pregunta queda cerrada

La conjetura Aaronson-Ambainis, abierta desde una charla de 2008, preguntaba si un algoritmo cuántico puede lograr una ventaja exponencial al leer datos cuando esos datos son completamente aleatorios, sin ningún patrón que explotar. La respuesta que entrega la nueva prueba es que no, dentro de un marco llamado modelo de consultas: para preguntas de sí o no, un algoritmo clásico puede aproximar la probabilidad de que el algoritmo cuántico responda 'sí' en la gran mayoría de los casos, sin necesitar exponencialmente más lecturas del dato. El resultado lleva el nombre de Scott Aaronson y Andris Ambainis, quienes conectaron la pregunta cuántica con una propiedad de ciertas fórmulas matemáticas llamadas polinomios. La prueba, hecha por David Turturean de Physical Superintelligence (PSI), cierra esa brecha teórica después de casi dos décadas.

Cómo se mide la ventaja: el modelo de consultas

Para comparar máquinas cuánticas y clásicas, los investigadores no cuentan cada operación que realiza una computadora, sino cuántas veces necesita consultar su entrada: eso es una consulta. Una consulta clásica abre una caja y lee lo que hay adentro. Una consulta cuántica puede interactuar con varias cajas a la vez usando superposición, aunque no revela todo su contenido de inmediato; el algoritmo combina esos efectos para extraer un patrón oculto. Este marco te da una forma precisa de comparar cuánta información necesita cada tipo de máquina, pero es más estrecho que afirmar que una computadora convencional puede reproducir todo lo que hace una cuántica: solo habla de lecturas de datos, no del cómputo total.

Por qué la estructura cambiaba el resultado: el caso de Shor

Las ventajas cuánticas mejor conocidas dependen de patrones en el problema. El algoritmo de factorización de Peter Shor, de 1994, encuentra el período de una función que se repite, y esa periodicidad es justamente la estructura que el algoritmo cuántico aprovecha para superar a cualquier método clásico conocido. La pregunta de Aaronson y Ambainis apuntaba al caso opuesto: ¿qué pasa cuando no hay esa estructura favorable, cuando la entrada es una cadena de ceros y unos generada al azar? La prueba establece que, en ese escenario sin estructura, la ventaja exponencial en lecturas desaparece para la gran mayoría de las entradas, lo que refuerza por qué las aplicaciones cuánticas prometedoras suelen apoyarse en problemas con algún tipo de patrón matemático o físico.

La pieza matemática que faltaba

Un resultado previo ya mostraba que la probabilidad de que un algoritmo cuántico responda 'sí' puede describirse mediante una fórmula matemática, cuya complejidad está limitada por el número de consultas que hace el algoritmo. Aaronson y Ambainis propusieron que, en esas fórmulas, siempre debe existir al menos un bit de entrada con un efecto medible sobre el resultado, cada vez que ese resultado varía de forma significativa entre entradas distintas. Esa propiedad le daría a una computadora clásica una estrategia concreta: en lugar de leer todos los bits, podría leer primero los más influyentes, actualizar su estimación y repetir el proceso hasta que el resto de los datos dejara de importar. Lo que faltaba era la garantía de que ese proceso avanzara sin necesitar, de todos modos, un número exponencial de lecturas — y esa garantía es exactamente lo que la nueva prueba entrega.

La construcción de la prueba

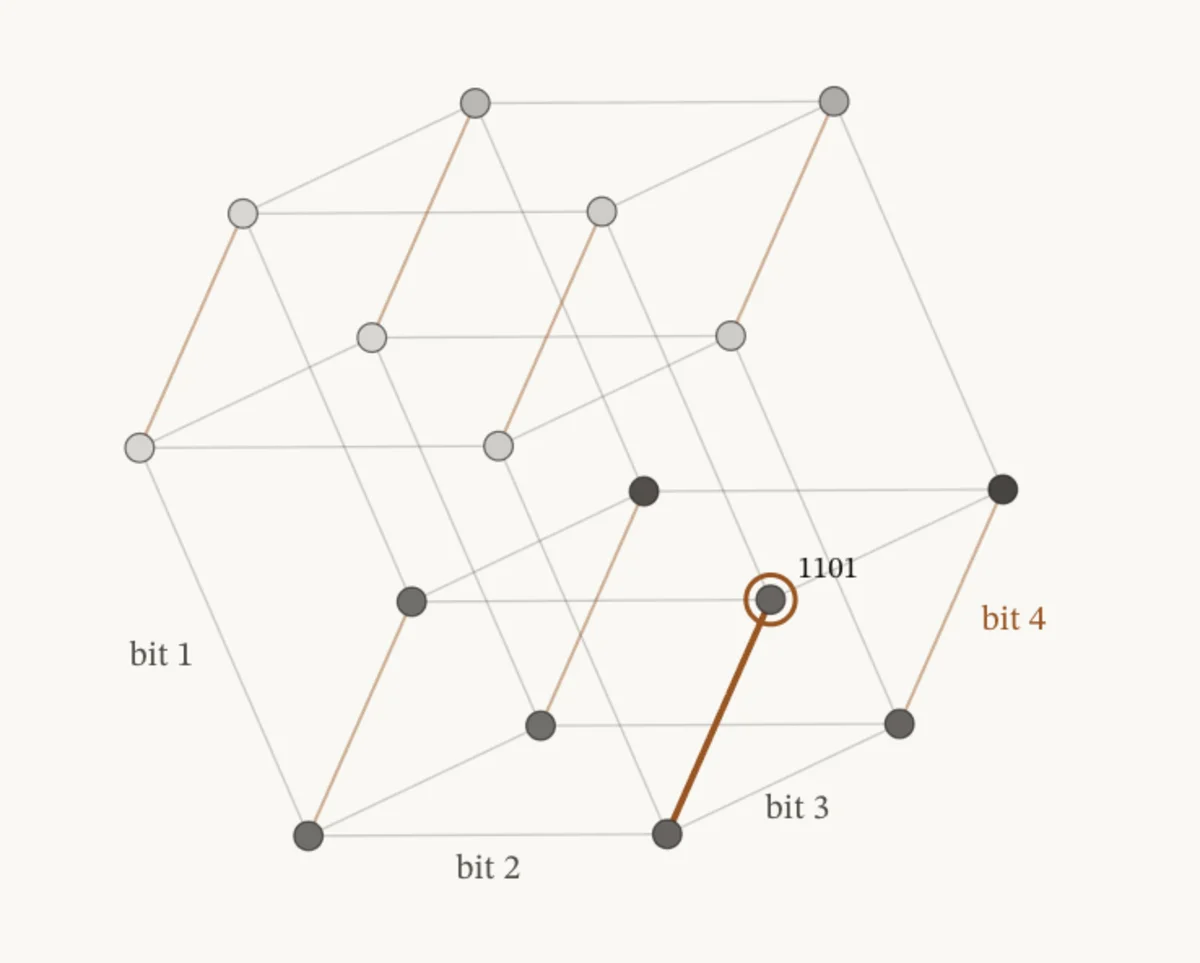
Turturean construyó su demostración sobre un enfoque desarrollado antes por Shachar Lovett y Jiapeng Zhang, que examina qué entradas producen resultados por encima o por debajo de una serie de umbrales para estudiar cómo los cambios en los datos afectan el resultado final. El avance central es un nuevo método para emparejar distintas configuraciones de datos de entrada, siguiendo restricciones sobre dónde esas configuraciones coinciden o difieren, lo que permite conectar el cambio de un bit individual con el comportamiento de la fórmula completa; este paso fortalece un resultado matemático anterior conocido como el Lema de la Mariposa de David Reimer. La prueba también encontró que una afirmación propuesta originalmente por Lovett y Zhang no se sostiene en su forma general, y la reemplazó por un resultado distinto sin abandonar la estrategia más amplia de esos autores. De forma complementaria, investigadores de Stanford —Guy Blanc, Jordan Docter, Carmen Strassle y Li-Yang Tan— habían mostrado en agosto de 2026 una versión más restringida del mismo fenómeno, limitada a un número fijo de rondas de lectura, y según PSI revisaron la prueba completa y prepararon una explicación más breve para especialistas.

Cómo se encontró: un sistema de IA y verificación en Lean

PSI usó un sistema de investigación propio en el que múltiples instancias de un modelo no público de Anthropic buscaron literatura existente, propusieron ideas, combinaron enfoques y pusieron a prueba argumentos; algunas instancias coordinaban el trabajo de otras. Turturean seleccionó y definió el problema, operó el sistema y pidió a un modelo que ensamblara los resultados en un primer borrador, que luego revisó y editó personalmente, asumiendo la responsabilidad de su corrección. La primera prueba completa apareció durante el tercer día de la ejecución, con una garantía más débil que la versión final; después, al pedirle al sistema que investigara problemas abiertos relacionados, el bound matemático se mejoró dos veces más. El teorema principal y la formulación original de la conjetura se formalizaron en Lean, un asistente de pruebas cuyo núcleo de software verificó que cada paso lógico fuera correcto, y las tres versiones de la prueba pasaron por esa verificación.

Qué no demuestra el teorema

El resultado no garantiza una estimación precisa para cada entrada individual, sino para la gran mayoría de entradas generadas al azar, dentro de un margen de error elegido de antemano. Tampoco cubre todo tipo de cómputo cuántico ni dice nada sobre el tiempo total de cómputo: solo acota cuántas veces hace falta leer los datos, dejando fuera el trabajo necesario para decidir qué leer a continuación o para calcular la respuesta final. La garantía explícita, además, permite un número considerable de lecturas cuando se exige mucha precisión, así que probar que el crecimiento no es exponencial no implica que el método sea práctico en la actualidad. Por eso el teorema deja espacio para ventajas cuánticas moderadas incluso sobre entradas sin estructura, y para ventajas mucho mayores en problemas que sí tienen algún patrón explotable.

Lo que queda abierto

El propio artículo señala que no establece la garantía más fuerte posible sobre cuánta influencia debe tener un bit de entrada; mejorar esa cota ajustaría todavía más el límite sobre cuántas lecturas necesita una computadora clásica. También queda pendiente si el paso central de emparejamiento de configuraciones de datos puede lograrse mediante una construcción directa, en lugar del argumento algebraico que usa la prueba actual, lo que podría volver esa parte del razonamiento más clara y más fácil de reutilizar. Con la conjetura resuelta, el terreno queda abierto para investigar qué más revelan estos métodos sobre otros problemas de matemática y de teoría de la computación.

Qué te llevas

  • La conjetura Aaronson-Ambainis, abierta desde 2008, queda resuelta: sin estructura en los datos, la ventaja cuántica en lecturas de información desaparece para la mayoría de entradas aleatorias.

  • El resultado habla de consultas al dato, no de tiempo de cómputo total, así que no cierra la puerta a ventajas cuánticas prácticas, sobre todo en problemas con estructura como la factorización de Shor.

  • La prueba se construyó sobre el trabajo de Lovett y Zhang, corrigió una de sus afirmaciones y fortaleció el Lema de la Mariposa de Reimer con un nuevo método de emparejamiento de datos.

  • Un sistema de IA de PSI, con instancias de un modelo no público de Anthropic, encontró y mejoró la prueba en pocos días; un investigador humano definió el problema, revisó el borrador y asumió responsabilidad por su corrección.

  • La demostración completa se verificó formalmente en Lean, pero entender por qué funciona y qué implica sigue siendo trabajo de los investigadores que la revisaron.

Este resumen lo escribimos a partir de las notas oficiales del anuncio. Lo que no estaba ahí, no está aquí.

Tu pedido

¿Quieres una clase de esto?

Si varias personas la piden, entra al programa como un video animado de 5 a 8 minutos. No hace falta dejar correo ni nombre.

Más del radar

Otras señales de estos días